Alexa & AI
vLLM push-based KV transfer improves inference speed
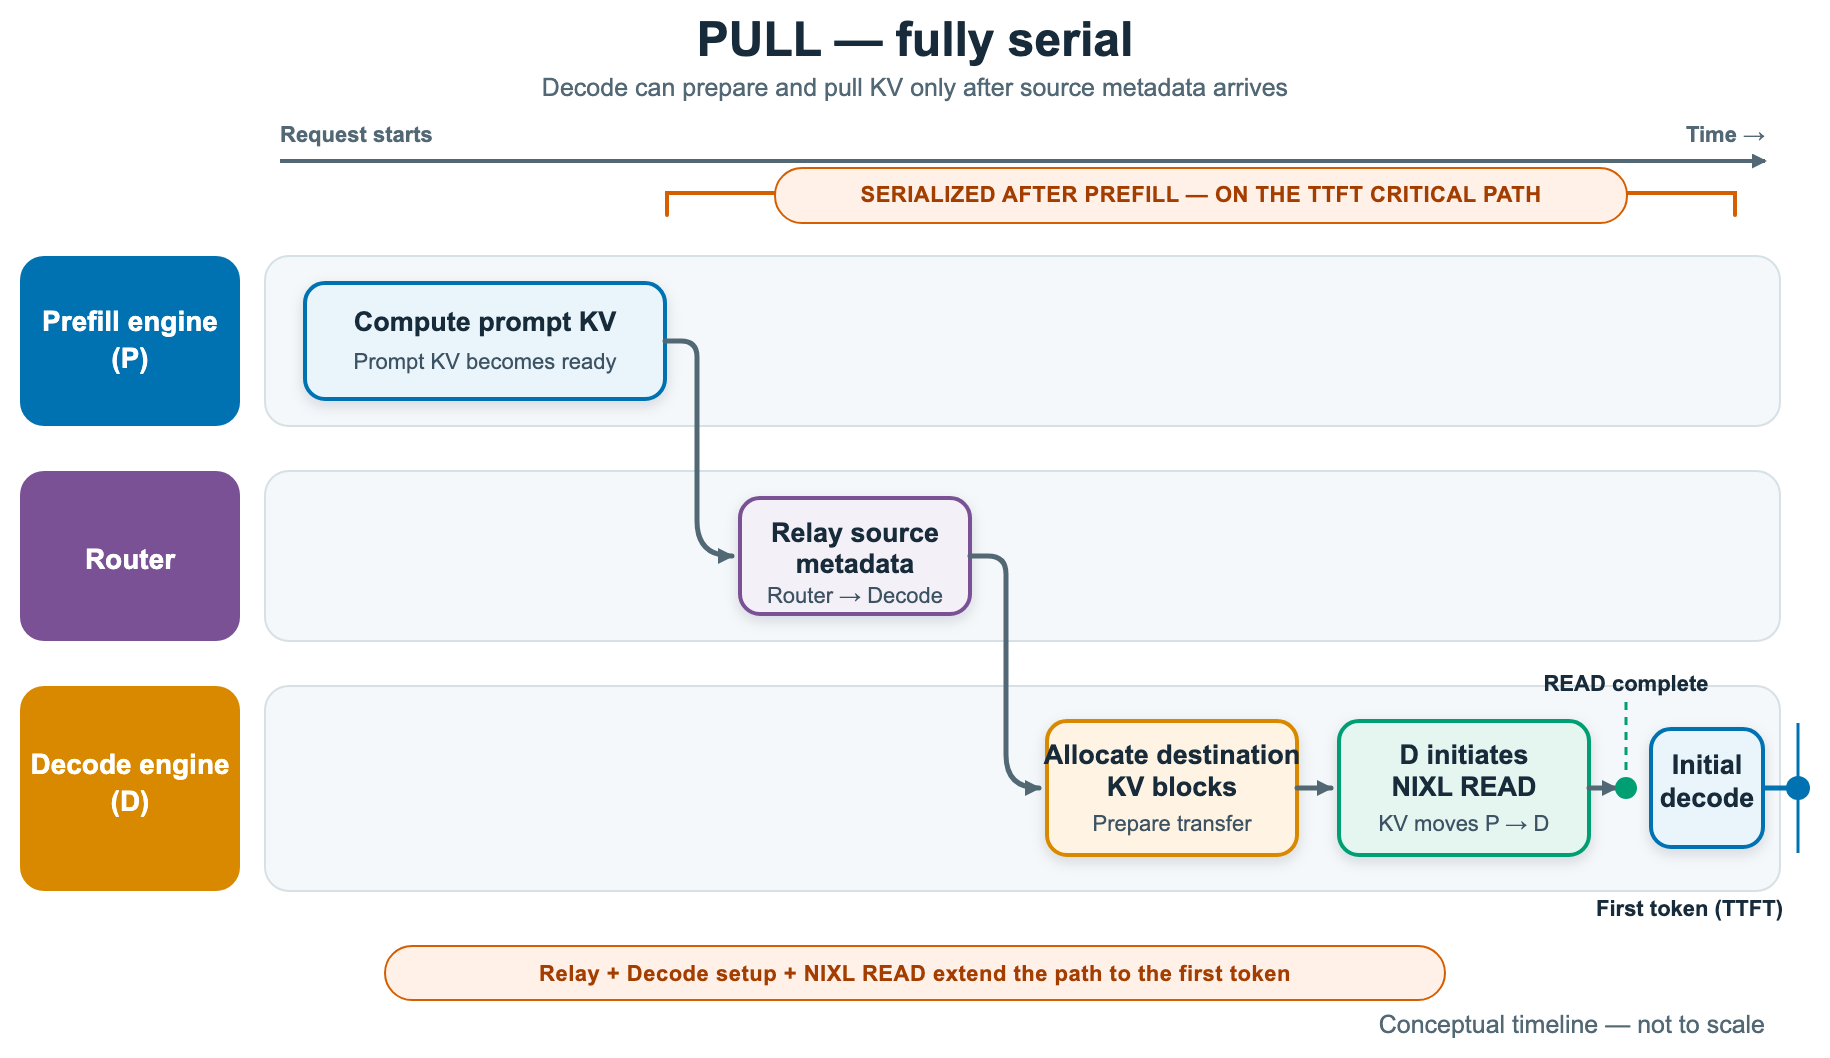
vLLM's new push-based KV transfer reduces latency for disaggregated LLM inference, offering up to 3x better TTFT on AWS EC2.
19 October 2026 · 4 minLov Singh
Topic
vLLM's new push-based KV transfer reduces latency for disaggregated LLM inference, offering up to 3x better TTFT on AWS EC2.